Windows · Python 3.12.4. 본문의 첫 예제를 실행하여 표준 출력과 예상 결과가 일치함을 확인했습니다. 연습문제의 모든 입력을 검증한 것은 아닙니다.
이 글의 순서 4개 단락
점수 딕셔너리를 값 기준으로 정렬할 때는 sorted()에 무엇을 전달했는지부터 살펴보면 이해하기 쉽습니다. 딕셔너리를 직접 전달하면 이름이 하나씩 넘어가고, items()를 전달하면 이름과 점수로 이루어진 튜플이 하나씩 넘어갑니다.
이 글의 예제 환경은 Python 3.12입니다. 입력은 코드에 포함되어 있으며 별도의 파일이나 사용자 입력이 필요하지 않습니다.
key 함수에 들어오는 요소 비교하기
다음 예제는 이름을 키로, 점수를 값으로 저장합니다. 두 함수는 받은 요소를 출력한 다음 해당 점수를 정렬 기준으로 반환합니다.
scores = {"Mina": 90, "Jin": 80, "Ara": 90}


def key_from_dict(name):
    print("딕셔너리 요소:", name)
    return scores[name]


def key_from_items(item):
    print("items 요소:", item)
    return item[1]


names = sorted(scores, key=key_from_dict)
pairs = sorted(scores.items(), key=key_from_items)

print("이름 결과:", names)
print("항목 결과:", pairs)
print("빈 딕셔너리 결과:", sorted({}.items(), key=key_from_items))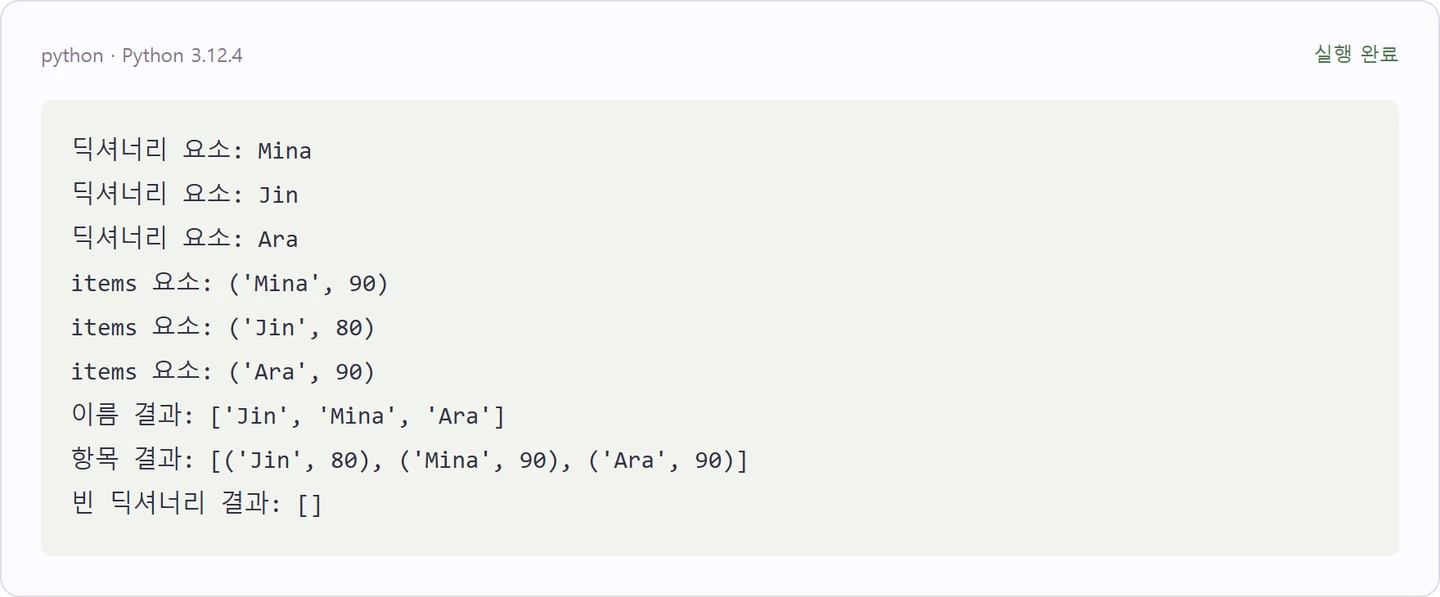
예상 출력은 다음과 같습니다.
딕셔너리 요소: Mina
딕셔너리 요소: Jin
딕셔너리 요소: Ara
items 요소: ('Mina', 90)
items 요소: ('Jin', 80)
items 요소: ('Ara', 90)
이름 결과: ['Jin', 'Mina', 'Ara']
항목 결과: [('Jin', 80), ('Mina', 90), ('Ara', 90)]
빈 딕셔너리 결과: []
왜 결과가 다를까?
scores를 직접 순회하면 딕셔너리의 키인 이름이 나옵니다. 따라서 key_from_dict는 Mina 같은 문자열을 받고, scores[name]으로 점수를 찾아 반환합니다. 정렬 대상 자체는 이름이므로 결과도 이름의 리스트입니다.
반면 scores.items()의 각 요소는 ('Mina', 90) 같은 키·값 튜플입니다. key_from_items는 튜플의 두 번째 요소인 item[1]을 점수로 반환합니다. 정렬 대상은 튜플이므로 결과는 튜플을 담은 리스트입니다. 두 경우 모두 key가 반환한 점수는 정렬 기준이며, 그 값이 결과의 각 요소를 대체하지는 않습니다. sorted()는 원본을 바꾸지 않고 새 리스트를 만듭니다. Python 정렬 기법
함수를 짧게 표현하면 sorted(scores.items(), key=lambda item: item[1])입니다. lambda item: item[1]도 항목 하나를 받아 점수를 반환하는 함수입니다.
동점과 경계 조건
Mina와 Ara는 모두 90점입니다. 딕셔너리는 삽입 순서를 유지하고, Python 정렬은 같은 정렬 기준을 가진 요소의 입력 순서를 유지하므로 Mina가 Ara보다 앞에 남습니다. reverse=True로 점수를 내림차순으로 정렬해도 동점끼리의 상대 순서는 유지됩니다. 다만 이름까지 정렬 기준으로 추가하면 동점의 이름 순서는 그 추가 기준에 따라 달라질 수 있습니다. 딕셔너리 자료형, 정렬 안정성
빈 딕셔너리에는 요소가 없으므로 key 함수가 호출되지 않고 결과는 빈 리스트 []입니다. 또 sorted(scores, key=lambda item: item[1])에서 item은 튜플이 아니라 이름 문자열이므로, item[1]은 점수가 아니라 이름의 두 번째 글자입니다. 한 글자짜리 이름이라면 인덱스 오류도 발생합니다. 점수를 꺼낼 때는 정렬 대상에 맞춰 scores[name] 또는 item[1]을 사용하세요.
연습문제와 풀이
위 scores에서 점수가 높은 항목부터 나열하되, 동점인 항목은 기존 순서를 유지해 보세요. 결과에는 이름과 점수가 모두 있어야 합니다.
result = sorted(scores.items(), key=lambda item: item[1], reverse=True)
print(result)
예상 결과는 [('Mina', 90), ('Ara', 90), ('Jin', 80)]입니다. items()가 이름과 점수를 함께 제공하고, reverse=True가 점수의 정렬 방향을 바꿉니다. 같은 90점인 두 항목의 상대 순서는 그대로입니다.
CHECK THE SOURCE
참고한 공식 문서
기능 설명은 위 문서를 참고했으며, 예제의 입력·결과와 한계는 본문에 따로 기록했습니다.