Windows · Python 3.12.4. 본문의 첫 예제를 실행하여 표준 출력과 예상 결과가 일치함을 확인했습니다. 연습문제의 모든 입력을 검증한 것은 아닙니다.
이 글의 순서 4개 단락
한글 텍스트 파일을 읽다가 UnicodeDecodeError가 발생했다면 파일을 찾은 뒤에 바이트를 문자로 바꾸는 단계에서 문제가 생긴 것일 수 있습니다. 파일을 저장한 인코딩과 읽을 때 지정한 인코딩이 다르면 이런 오류가 발생할 수 있습니다. 작은 파일을 직접 만들어 두 읽기 방법을 비교해 보겠습니다.
CP949 파일을 만들어 비교하기
실행 환경은 Python 3.12입니다. 표준 라이브러리만 사용하며 Windows에서도 실행할 수 있도록 임시 폴더에 파일을 만듭니다. 코드에 넣을 입력 문자열은 가 Python입니다. UTF-8로 저장한 .py 파일에 아래 코드를 붙여 넣어 실행하세요. 터미널도 한글 출력을 지원해야 예상 결과를 그대로 볼 수 있습니다.
from pathlib import Path
from tempfile import TemporaryDirectory

text = "가 Python"

with TemporaryDirectory() as temp_dir:
    path = Path(temp_dir) / "sample.txt"
    path.write_text(text, encoding="cp949")

    print("파일 바이트:", path.read_bytes().hex(" "))

    try:
        path.read_text(encoding="utf-8")
    except UnicodeDecodeError:
        print("UTF-8 읽기: UnicodeDecodeError")

    correct = path.read_text(encoding="cp949")
    print("CP949 읽기:", correct)

    ignored = path.read_text(encoding="utf-8", errors="ignore")
    print("오류 무시:", repr(ignored))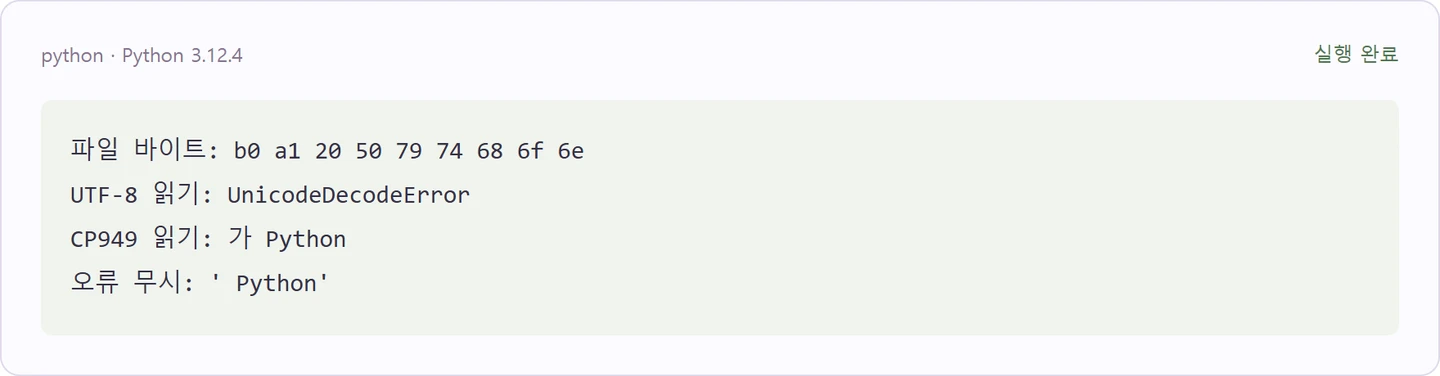
예상 표준 출력은 다음과 같습니다.
파일 바이트: b0 a1 20 50 79 74 68 6f 6e
UTF-8 읽기: UnicodeDecodeError
CP949 읽기: 가 Python
오류 무시: ' Python'TemporaryDirectory()는 실습에 필요한 폴더를 만들고 블록이 끝나면 정리합니다. 기존 파일이나 특정 사용자 경로는 필요하지 않습니다. 이 예제는 예상 결과를 제시한 것이며, 실행 결과를 실측한 것은 아닙니다.
바이트를 문자로 바꾸는 과정
write_text(..., encoding="cp949")는 문자열을 CP949 규칙에 따라 바이트로 인코딩해 저장합니다. read_bytes()로 확인하면 가에 해당하는 바이트는 b0 a1입니다. 그 뒤의 20은 공백이고 나머지는 Python의 바이트입니다.
텍스트를 읽을 때는 이 바이트를 지정된 규칙으로 다시 문자로 디코딩합니다. 예제의 b0 a1은 UTF-8에서 유효한 문자 시작 바이트가 아니므로 UTF-8 읽기는 UnicodeDecodeError를 일으킵니다. try와 except는 그 오류를 잡아 비교를 계속하게 합니다. 반면 CP949로 읽으면 처음 저장한 가 Python이 돌아옵니다.
파일의 인코딩을 알고 있다면 실제 파일을 읽을 때도 open("파일명.txt", encoding="cp949")처럼 명시하세요. 인코딩을 생략한 텍스트 읽기의 기본값은 환경 설정에 따라 달라질 수 있으므로 서로 다른 환경에서 같은 파일을 다룰 때는 특히 명시하는 편이 좋습니다. 자세한 동작은 Python 3.12의 open 문서와 Unicode HOWTO를 참고하세요.
흔한 실수와 경계 조건
errors="ignore"는 인코딩을 알아내거나 고치는 옵션이 아닙니다. 위 예제에서는 UTF-8 규칙으로 처리할 수 없는 바이트가 빠져 가가 사라집니다. 오류가 보이지 않아도 원본 내용이 손실될 수 있으므로 정상적인 파일 읽기 방법으로 사용하지 마세요. errors="replace" 역시 문제 부분을 대체 문자로 바꾸므로 원문을 복구하지 않습니다.
CP949가 모든 UnicodeDecodeError의 정답은 아닙니다. 파일을 만든 프로그램의 저장 설정이나 제공자의 안내에서 인코딩을 먼저 확인하세요. 자동 추정은 바이트를 바탕으로 후보를 고르는 방법이지만, 같은 바이트가 여러 인코딩에서 유효할 수 있어 확정적인 판별은 아닙니다. 디코딩에 성공했더라도 글자가 깨져 보이면 잘못된 인코딩을 선택했을 수 있습니다. 반대로 영문과 숫자만 있는 파일은 여러 인코딩에서 같은 글자로 읽혀 차이가 드러나지 않을 수 있습니다.
또한 CP949로 표현할 수 없는 문자를 CP949 파일에 쓰려 하면 읽기 오류가 아닌 UnicodeEncodeError가 발생할 수 있습니다. 파일이 없거나 읽을 권한이 없는 경우도 별도의 파일 접근 오류이므로 인코딩 변경만으로 해결되지 않습니다.
연습: 정상 읽기와 무시한 결과 비교하기
위 코드의 print("오류 무시:", repr(ignored)) 다음에 print("내용이 같은가:", correct == ignored)를 추가하면 무엇이 출력될까요?
풀이: 내용이 같은가: False가 출력됩니다. CP949로 읽은 correct에는 가가 있지만, UTF-8로 읽으면서 오류를 무시한 ignored에서는 해당 바이트가 빠졌기 때문입니다. 오류를 숨기는 것과 원래 내용을 보존하는 것은 다릅니다.
CHECK THE SOURCE
참고한 공식 문서
- Python 3.12: open() ↗
- Python 3.12: Unicode HOWTO ↗
- Python 3.12: tempfile — Generate temporary files and directories ↗
- Python 3.12: pathlib — Object-oriented filesystem paths ↗
기능 설명은 위 문서를 참고했으며, 예제의 입력·결과와 한계는 본문에 따로 기록했습니다.